EECS151 课程笔记:数字电路设计与三级流水线 RISC-V 处理器
2024 年春季我作为访问学生在 Berkeley 修读了 EECS151(Introduction to Digital Design and Integrated Circuits,授课教授 J. Wawrzynek)以及配套的 ASIC Lab。这门课从 Verilog 和 FPGA 讲起,经过 RISC-V 指令集、存储器、加法器与乘法器,一直讲到布局布线。实验部分走完了一条完整的 ASIC 流程:RTL 仿真、逻辑综合、布局布线,以及综合后和布线后的门级仿真。课程资料、实验代码和期末项目分别整理在 2024_spring_eecs151 与 EECS151-Project 两个仓库中。
实验
实验在教学服务器上用 Hammer 调用 Synopsys VCS 与 Cadence Innovus,工艺库是开源的 SkyWater 130nm(sky130)。
| 实验 | 内容 | 我的实现 |
|---|---|---|
| Lab 1 | 熟悉服务器环境与 Hammer 工具流程 | 环境配置截图 |
| Lab 2 | FIR 滤波器的 RTL 仿真与门级仿真,在 DVE 中读波形 | 时序图与原理图分析 |
| Lab 3 | 把 GCD 电路拆分为 datapath 与 control 两部分,实现除法器 | gcd_datapath.v、gcd_control.v、divider.v 及测试平台 |
| Lab 4 | 用 FIFO 和 ready/valid 握手封装 GCD 协处理器,加入 ALU | gcd_coprocessor.v、fifo.v、alu.v |
| Lab 5 | 用仲裁器把请求分发给两个 GCD 单元,在 Innovus 中完成布局布线 | gcd_arbiter.v,布线后 64 条时序路径全部满足约束,WNS 为 0 |
| Lab 6 | 基于单口 SRAM 实现向量点积 | dot_product.v 及测试平台 |
这几次实验反复练习的是同一种设计习惯:先把 datapath 和 control 分开,再用 ready/valid 握手把模块串起来。Lab 3 的 GCD 要求逐周期写出 A_reg、B_reg 以及它们下一拍的值,这个练习让我习惯先在纸面上推一遍寄存器转移,再去写 Verilog。Lab 5 布线后的时序报告里,slack 最小的几条路径都从结果 FIFO 的寄存器出发,终点是 GCD datapath 中的 A、B 寄存器。
期末项目:三级流水线 RISC-V 处理器
期末项目是我和 Timonty Chu 两人组队完成的:设计一个三级流水线的 RISC-V 处理器,并用 Hammer 在 sky130 上完成综合与布局布线。项目分四个 checkpoint 和一次最终验收,Verilog 代码约 2300 行,综合目标时钟周期为 20 ns。
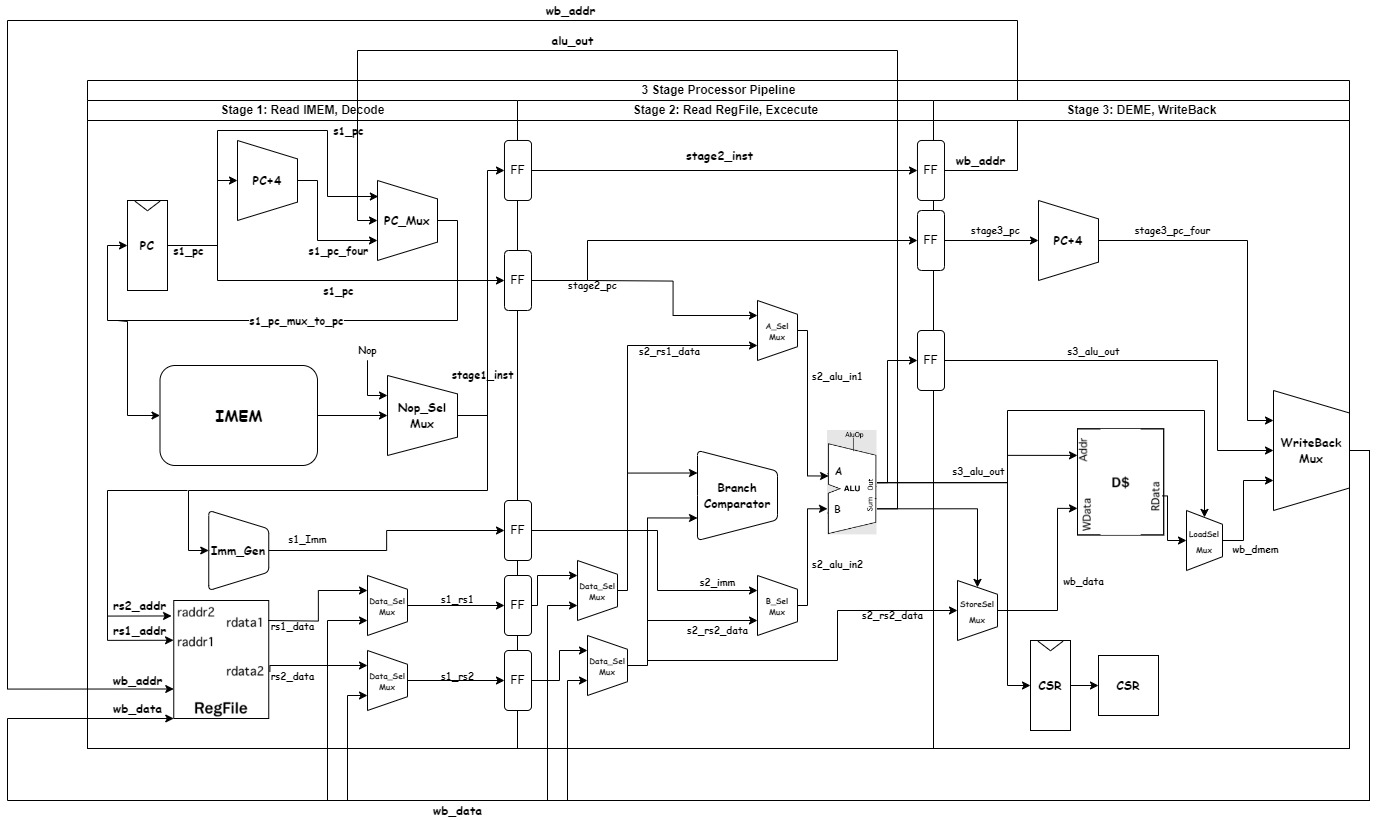
三级流水线的划分如下:
- 第一级: 读 IMEM、译码、生成立即数,并读取寄存器堆。
- 第二级: 选择 ALU 操作数、执行运算,分支比较器也在这一级给出跳转结果。
- 第三级: 访问数据 cache、按访存类型选择 load 结果,写回寄存器堆,并写 CSR。
实现中有三处需要特别处理:
- 数据冒险: 在第一级和第二级的操作数入口各放一组
Data_Sel多路选择器,把写回级的数据前递给后续指令。 - 控制冒险: 跳转在第二级确定,此时第一级已经取入的指令通过
Nop_Sel替换为 nop。 - 访存停顿: cache 读结果要晚一个周期返回,所以 load 之后以及 icache、dcache 未命中时,由
StallHandler统一暂停 PC 和流水线。
数据 cache 是直接映射、写回式的,共 64 行,每行 512 bit,并按块记录 dirty 位。
测试方面,我们先用 Verilog 测试平台做随机激励,再扩展 Python 脚本 ALUTestGen.py,为 R 型和 I 型指令生成测试向量,并用 $readmemb 读入逐条比对。完成 RTL 验证后,还需要在综合后和布线后分别跑一遍门级仿真。
2026.09.28